Tech talk: kan ETL in de cloud zonder programmeren? (deel 2)
In dit vervolg op deel 1 toon ik hoe we een ETL-proces opzetten voor een klant in de horecasector. Omdat de klant Power BI als front-endtool wilde gebruiken, stelden we Microsoft voor als geschikte leverancier voor de cloudmigratie. Azure Portal is de gebruiksvriendelijkste cloudinterface en heeft grondige documentatie, wat het een goede optie voor beginners maakt. Het enige nadeel is dat Azure iets duurder is dan concurrenten.
Voor deze proof of concept was er maar één databron, hier in het paars aangeduid:
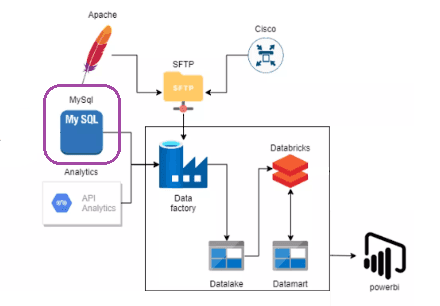
Bestaande data-architectuur
Extractie (ETL)
De eerste ETL-stap is extractie. We moesten bijna 30 tabellen uit de MySQL-database ophalen. Daarvoor gebruikten we Azure Data Factory (ADF). Dit is inderdaad een van de weinige taken waarvoor geen code nodig is. Het lastige is dat de MySQL-database op een privénetwerk staat. U moet ADF dus instellen op een VM in dat netwerk. De installatie van een self-hosted integration runtime is niet eenvoudig. Voorzie op die VM ook een Java Runtime Environment om tabellen naar parquetbestanden te kunnen exporteren. Dat is een efficiënt formaat met metadata. Snappy is de standaardcompressie en die raden we sterk aan.
ADF heeft de volgende hiërarchie: Data Factory > Pipelines > Activities. Zodra ADF is verbonden met alle nodige middelen, in ons geval de MySQL-database, Azure Data storage en Databricks, kunt u data ophalen met zogenoemde 'copy activities'. ADF biedt twee opties: sjablonen voor gegevensinvoer en zelfgemaakte pipelines.
Bij de eerste optie scant u de databron en kiest u de gewenste tabellen. U kunt volledige tabellen kopiëren naar de bestemming van uw keuze.
Bij de tweede maakt u per databasetabel een aparte copy activity. Dat is omslachtig, maar u kunt er een SQL-query aan koppelen. Zo bespaart u veel opslagruimte als u verouderde kolommen wilt verwijderen of rijen wilt filteren, bijvoorbeeld op datum. Controleer ook of kolommen van het type datetime correct zijn opgehaald. Zo niet, dan is een typeconversie nodig.
Transformatie (ETL)
De tweede ETL-stap is transformatie. We gebruikten twee Spark-clusters, één voor ontwikkeling en één voor batchtaken, beheerd door de Databricks-omgeving. Databricks-notebooks zijn handig om code in Python te schrijven, in dit geval Pyspark, of om specifieke taken binnen het cluster in Scala te debuggen en op te volgen.
Laden (ETL)
De derde en laatste stap is laden. We moesten meerdere dimensie- en feitentabellen in parquetformaat in het datawarehouse plaatsen, een Azure SQL-database. Verrassend genoeg bleek ADF hier vrij beperkt. Meerdere parquetbestanden automatisch laden kan niet. Ook kunnen we belangrijke laadopties niet instellen, zoals tabellen leegmaken, verwijderen of overschrijven. Daarom plaatsten we laadscripts met een JDBC-driver in Databricks, met deze code:
df_name.write \
.format("jdbc") \
.option("url", "jdbc:postgresql:dbserver") \
.option("dbtable", "schema.tablename") \
.option("user", "username") \
.option("password", "password") \
.save()
Deze methode biedt veel mogelijkheden. Ze worden hier beschreven: JDBC To Other Databases - Spark 3.2.1 Documentation (apache.org)
Hierna
In deel 3 beschrijf ik een ander cloudproject: hoe we met AWS een klant helpen ETL-processen en datawarehouses op te zetten.