Wordt uw AI-model minder nauwkeurig? Mogelijk is er sprake van drift
Machinelearningmodellen zijn krachtige hulpmiddelen om als organisatie slimmere beslissingen te nemen. Na verloop van tijd kunnen hun prestaties echter afnemen, omdat de data waarop ze werden getraind niet meer overeenkomen met de huidige situatie. Dat verschijnsel heet drift. We bekijken de verschillende soorten drift en bespreken eenvoudige stappen waarmee beslissers de modelprestaties kunnen bewaken, ook zonder expertise in data science.
Machinelearningmodellen zijn krachtige hulpmiddelen om als organisatie slimmere beslissingen te nemen. Na verloop van tijd kunnen hun prestaties echter afnemen, omdat de data waarop ze werden getraind niet meer overeenkomen met de huidige situatie. Dat verschijnsel heet drift. We bekijken de verschillende soorten drift en bespreken eenvoudige stappen waarmee beslissers de modelprestaties kunnen bewaken, ook zonder expertise in data science.
Wat is drift in machine learning?
Drift in machine learning treedt op wanneer een model dat vroeger goede voorspellingen maakte, slechter begint te presteren. Het gaat niet over auto's die door een bocht glijden, maar over een verandering door de tijd in de dataomgeving, waardoor het oorspronkelijke model minder doeltreffend wordt. Drift ontstaat wanneer de kenmerken van de invoerdata veranderen of wanneer het verband tussen de data en het beoogde resultaat verschuift.
Stel: u bouwde een model op basis van de klantdata van vorig jaar. Als de demografische kenmerken of het koopgedrag van uw klanten dit jaar veranderen, voorspelt het model trends mogelijk minder goed. Die prestatiedaling is drift in de praktijk.
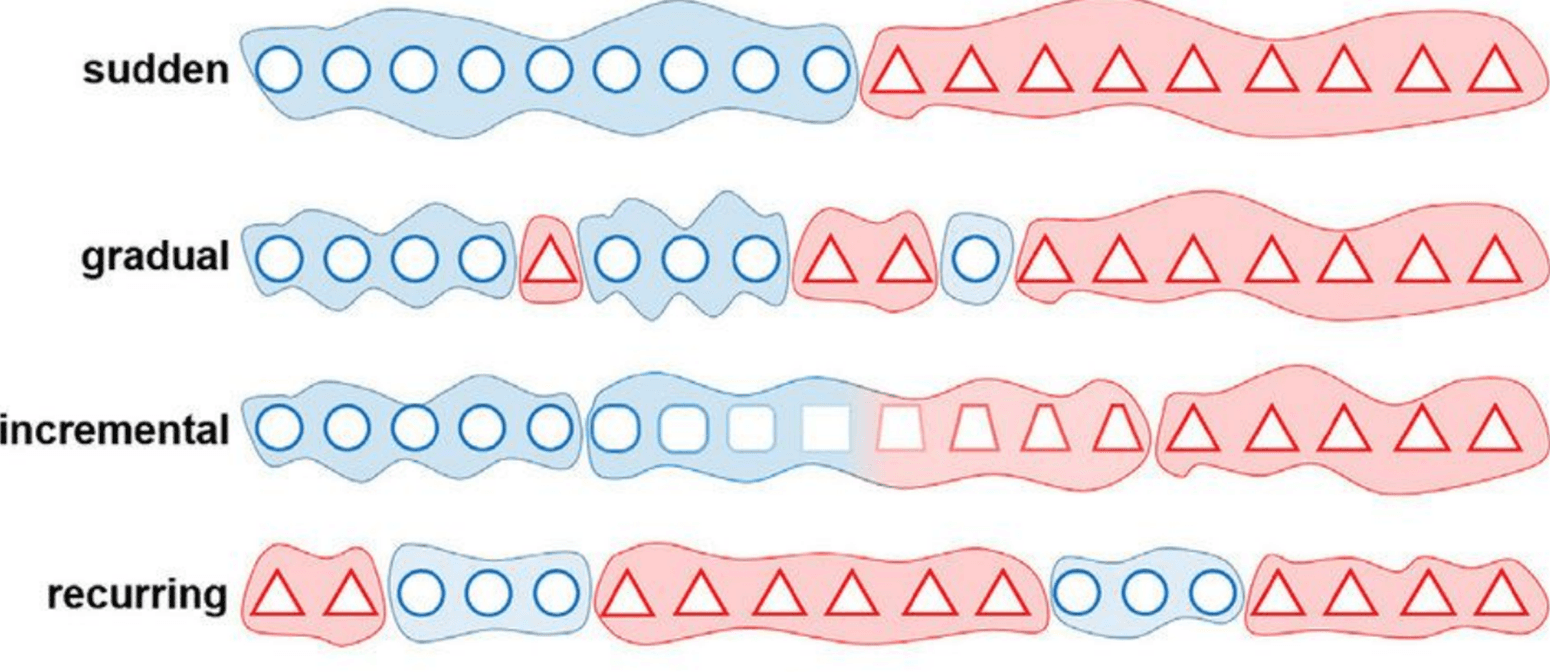
Drift kan zich op verschillende manieren voordoen. Soms ontstaat hij plots, bijvoorbeeld wanneer een nieuwe methode voor dataverzameling wordt ingevoerd. Soms gaat het geleidelijk, terwijl de onderliggende patronen langzaam veranderen. Drift kan ook een terugkerend patroon volgen, zoals seizoensveranderingen. Drift vroeg herkennen helpt u sterke prestatiedalingen te voorkomen.
De vier soorten drift
Begrijpen welk type drift uw model beïnvloedt, is essentieel om de juiste tegenmaatregel te kiezen.
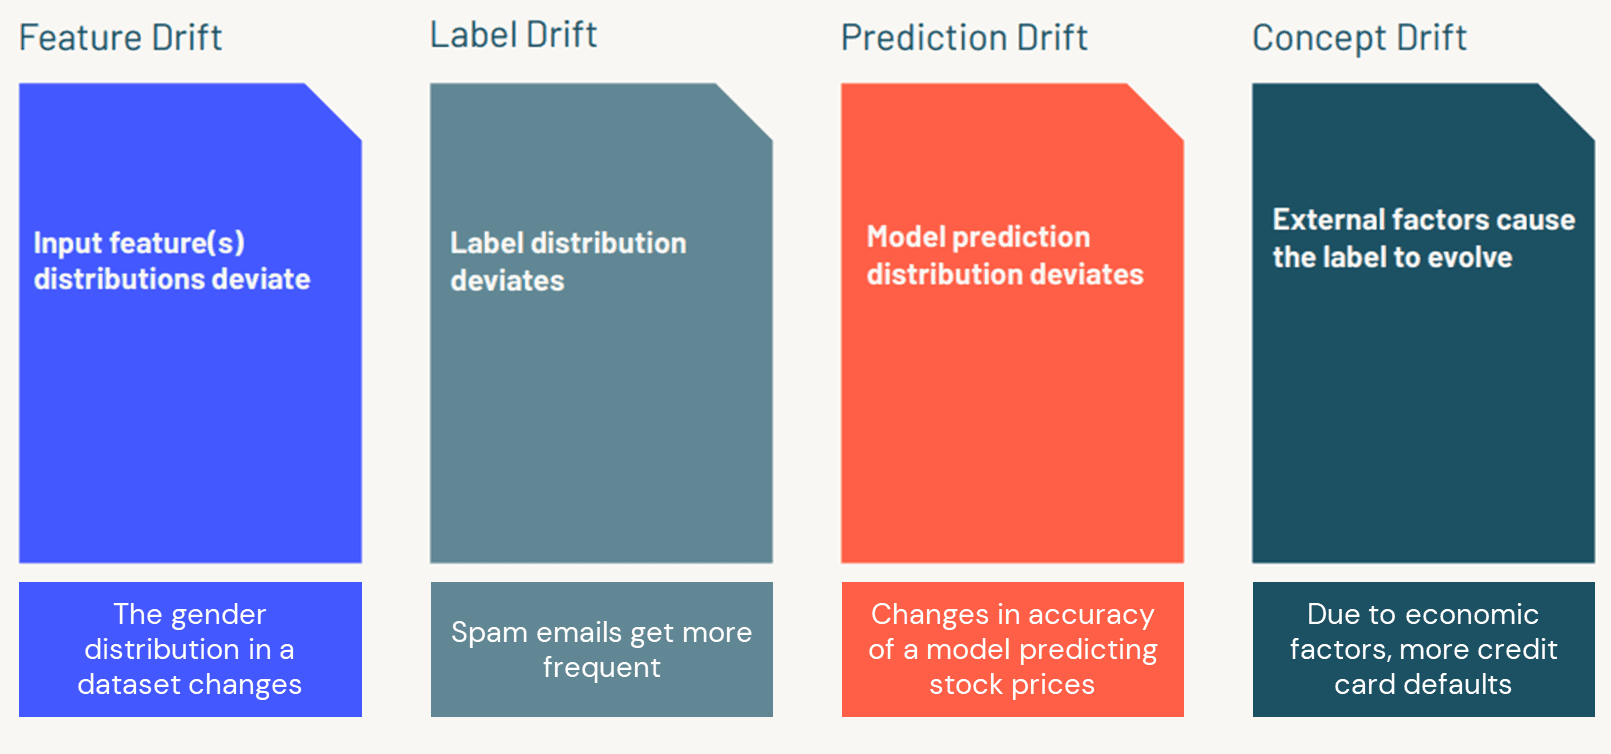
1. Feature drift
Feature drift verwijst naar veranderingen in de invoervariabelen waarop uw model steunt. Stel dat uw oorspronkelijke trainingsdata vooral betrekking hadden op vrouwen. Als uw nieuwe data na verloop van tijd vooral over mannen gaan, verandert de verdeling van uw kenmerken. Daardoor kan uw model de data verkeerd interpreteren en kan de accuracy dalen.
2. Label drift
Label drift treedt op wanneer de verdeling van de uitkomsten of labels verandert. Denk aan een model dat spammails herkent. Als het aandeel spam stijgt van 1% naar 10%, kan een model dat op data met een lager aandeel werd getraind belangrijke signalen beginnen te missen. De labels (spam tegenover geen spam) zijn dan verschoven en het model moet worden bijgewerkt.
3. Prediction drift
Prediction drift ontstaat wanneer de uitvoer van het model zelf onverwachte trends begint te vertonen. Dit kan gebeuren doordat het model data anders interpreteert. Als een model bijvoorbeeld vroeger een kans van 5% op een gebeurtenis voorspelde en nu 10% of 15% voorspelt zonder overeenkomstige verandering in de invoerdata, is er waarschijnlijk sprake van prediction drift.
4. Concept drift
Bij concept drift verandert het onderliggende verband tussen de invoerdata en de uitkomst. Dit is vaak het gevolg van externe factoren. Tijdens een economische terugval kunnen bijvoorbeeld de factoren die wanbetaling op kredietkaarten bepalen sterk verschuiven. Zelfs als de datakenmerken gelijk blijven, kunnen de voorspellingen verslechteren omdat het concept zelf is veranderd.
Databricks-demo op YouTube: https://youtu.be/tGckE83S-4s?si=uPUrJ86GayUkI-p4&t=470
Door drift in deze vier soorten op te splitsen, kunt u bepalen welk deel van uw dataomgeving is veranderd. Elk type vraagt een iets andere aanpak.
Drift opsporen en voorkomen
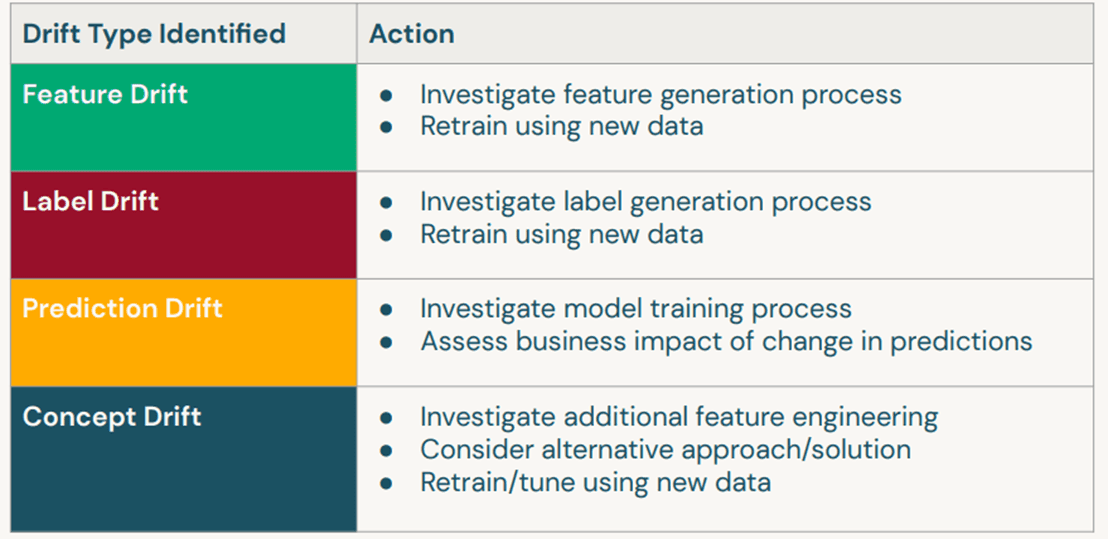
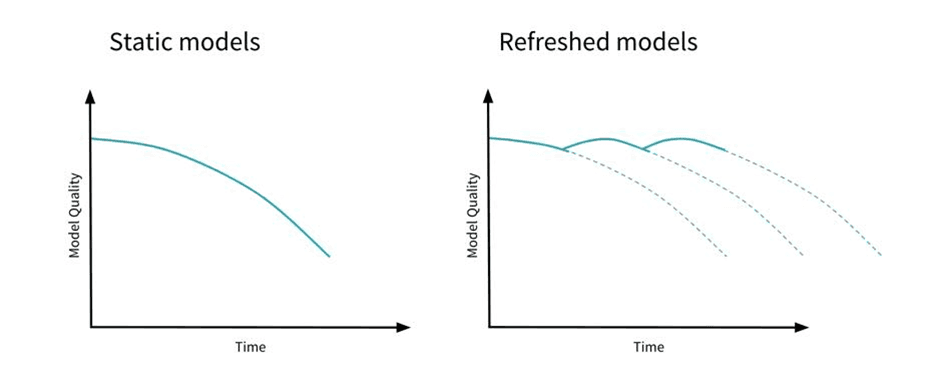
Als u begrijpt wat drift is en hoe hij zich kan uiten, is de volgende stap hem opsporen en ingrijpen. De gebruikelijkste strategie is uw model opnieuw trainen met nieuwe data die de huidige situatie weerspiegelen. Maar weten wanneer u opnieuw moet trainen is cruciaal om onnodige kosten of gemiste kansen te vermijden.
Uw data monitoren
U kunt drift monitoren door belangrijke meetwaarden op te volgen die veranderingen in de dataverdeling tonen. Controleer bijvoorbeeld gemiddelden, medianen of de spreiding van uw data om te zien of invoervariabelen beginnen af te wijken van hun historische patronen. Statistische tests, zoals de Kolmogorov-Smirnov-test of de Jensen-Shannon-divergentie, kunnen die veranderingen ook kwantificeren.
Modelprestaties opvolgen
Een andere methode is de prestatiemaatstaven van het model bewaken. Maatstaven zoals accuracy, de area under the curve (AUC) en root mean square error (RMSE) geven een betrouwbaar beeld van hoe goed uw model presteert. Als u merkt dat die waarden aanhoudend verslechteren, is het mogelijk tijd om het model opnieuw te trainen.
Databricks-demo op YouTube: https://youtu.be/tGckE83S-4s?si=0Nhky3lK7WJae2n0&t=654
Tools voor driftdetectie gebruiken
Moderne tools maken driftdetectie eenvoudiger. Een voorbeeld is Evidently AI, een opensourceplatform met vooraf ingestelde evaluaties om uitgebreide driftrapporten te maken. Evidently AI kan interactieve HTML-rapporten genereren die drift zichtbaar maken in verschillende aspecten van uw data, zoals de verdeling van kenmerken en prestatiemaatstaven.
De tool levert bovendien gestructureerde uitvoer. Zo kunt u de resultaten integreren in uw workflow. Wanneer drift een bepaalde drempel bereikt, kunt u bijvoorbeeld automatisch een nieuwe modeltraining starten. Zo helpt dit proces uw modellen ook na verloop van tijd accuraat te houden, zonder voortdurende handmatige controle.
Goede praktijken voor het omgaan met drift
Stel duidelijke drempels in
Bepaal welke prestatiemaatstaven het belangrijkst zijn voor uw bedrijf. Stel drempels in die bij verslechtering een controle of nieuwe modeltraining in gang zetten.
Automatiseer de monitoring
Automatiseer waar mogelijk de monitoring van data en prestaties. Automatische waarschuwingen helpen u snel te reageren voordat drift ernstige problemen veroorzaakt.
Train opnieuw wanneer nodig
De vuistregel is: train uw model opnieuw “wanneer dat nodig is”. Sommige omgevingen veranderen langzaam en vragen mogelijk een jaarlijkse hertraining. In snel veranderende omgevingen kan dat vaker nodig zijn.
Gebruik visuele rapporten
Visuele dashboards en interactieve rapporten maken data begrijpelijker voor beslissers. Ze tonen duidelijk wanneer drift optreedt, zodat u tijdig kunt handelen.
Alles samenbrengen
Drift in machine learning is een echte uitdaging, maar hoeft geen obstakel te zijn. Door de soorten drift te begrijpen en belangrijke indicatoren op te volgen, kunt u uw modellen goed laten presteren. Of u nu handmatig monitort of een geautomatiseerd proces opzet, het komt erop aan proactief te blijven en tijdig te reageren.
Voor beslissers betekent dit dat investeren in de juiste tools en strategieën vandaag morgen veel tijd en middelen kan besparen.
Voor data scientists benadrukt dit het belang van proactief modelbeheer. De vraag is niet óf uw model drift zal vertonen, maar wanneer. U moet klaarstaan om de oorzaak te vinden en het model waar nodig bij te werken, zodat uitval, fouten & kosten beperkt blijven.
Belangrijkste inzichten
1 - Drift in machine learning verwijst naar een daling van modelprestaties door de tijd, veroorzaakt door veranderingen in data of onderliggende verbanden.
2 - Er bestaan vier soorten drift: feature, label, prediction en concept drift. Ze kunnen modellen op verschillende manieren beïnvloeden.
3 - Vroege detectie is cruciaal. Monitor zowel uw data als de prestatiemaatstaven om drift op te sporen voordat uw bedrijf er last van krijgt.
4 - Tools zoals Evidently AI helpen uitgebreide rapporten te genereren en maken automatische hertraining mogelijk wanneer de prestaties dalen.
5 - Train alleen opnieuw wanneer nodig om prestatieverbeteringen en kosten in evenwicht te houden.
Met deze principes kunnen organisaties robuuste machinelearningmodellen onderhouden die zich aanpassen aan veranderende dataomgevingen. Die proactieve aanpak verbetert niet alleen de accuracy van modellen, maar ondersteunt ook de strategische planning op lange termijn.
Hebt u vragen of wilt u strategieën voor driftbeheer verder verkennen? Neem gerust contact op en plan een telefoongesprek met onze experts. We helpen u graag om de uitdagingen van goed presterende machinelearningmodellen aan te pakken.
Wat is drift in machine learning?
Drift in machine learning treedt op wanneer een model dat vroeger goede voorspellingen maakte, slechter begint te presteren. Het gaat niet over auto's die door een bocht glijden, maar over een verandering door de tijd in de dataomgeving, waardoor het oorspronkelijke model minder doeltreffend wordt. Drift ontstaat wanneer de kenmerken van de invoerdata veranderen of wanneer het verband tussen de data en het beoogde resultaat verschuift.
Stel: u bouwde een model op basis van de klantdata van vorig jaar. Als de demografische kenmerken of het koopgedrag van uw klanten dit jaar veranderen, voorspelt het model trends mogelijk minder goed. Die prestatiedaling is drift in de praktijk.
Drift kan zich op verschillende manieren voordoen. Soms ontstaat hij plots, bijvoorbeeld wanneer een nieuwe methode voor dataverzameling wordt ingevoerd. Soms gaat het geleidelijk, terwijl de onderliggende patronen langzaam veranderen. Drift kan ook een terugkerend patroon volgen, zoals seizoensveranderingen. Drift vroeg herkennen helpt u sterke prestatiedalingen te voorkomen.
De vier soorten drift
Begrijpen welk type drift uw model beïnvloedt, is essentieel om de juiste tegenmaatregel te kiezen.
1. Feature drift
Feature drift verwijst naar veranderingen in de invoervariabelen waarop uw model steunt. Stel dat uw oorspronkelijke trainingsdata vooral betrekking hadden op vrouwen. Als uw nieuwe data na verloop van tijd vooral over mannen gaan, verandert de verdeling van uw kenmerken. Daardoor kan uw model de data verkeerd interpreteren en kan de accuracy dalen.
2. Label drift
Label drift treedt op wanneer de verdeling van de uitkomsten of labels verandert. Denk aan een model dat spammails herkent. Als het aandeel spam stijgt van 1% naar 10%, kan een model dat op data met een lager aandeel werd getraind belangrijke signalen beginnen te missen. De labels (spam tegenover geen spam) zijn dan verschoven en het model moet worden bijgewerkt.
3. Prediction drift
Prediction drift ontstaat wanneer de uitvoer van het model zelf onverwachte trends begint te vertonen. Dit kan gebeuren doordat het model data anders interpreteert. Als een model bijvoorbeeld vroeger een kans van 5% op een gebeurtenis voorspelde en nu 10% of 15% voorspelt zonder overeenkomstige verandering in de invoerdata, is er waarschijnlijk sprake van prediction drift.
4. Concept drift
Bij concept drift verandert het onderliggende verband tussen de invoerdata en de uitkomst. Dit is vaak het gevolg van externe factoren. Tijdens een economische terugval kunnen bijvoorbeeld de factoren die wanbetaling op kredietkaarten bepalen sterk verschuiven. Zelfs als de datakenmerken gelijk blijven, kunnen de voorspellingen verslechteren omdat het concept zelf is veranderd.
Databricks-demo op YouTube: https://youtu.be/tGckE83S-4s?si=uPUrJ86GayUkI-p4&t=470
Door drift in deze vier soorten op te splitsen, kunt u bepalen welk deel van uw dataomgeving is veranderd. Elk type vraagt een iets andere aanpak.
Drift opsporen en voorkomen
Als u begrijpt wat drift is en hoe hij zich kan uiten, is de volgende stap hem opsporen en ingrijpen. De gebruikelijkste strategie is uw model opnieuw trainen met nieuwe data die de huidige situatie weerspiegelen. Maar weten wanneer u opnieuw moet trainen is cruciaal om onnodige kosten of gemiste kansen te vermijden.
Uw data monitoren
U kunt drift monitoren door belangrijke meetwaarden op te volgen die veranderingen in de dataverdeling tonen. Controleer bijvoorbeeld gemiddelden, medianen of de spreiding van uw data om te zien of invoervariabelen beginnen af te wijken van hun historische patronen. Statistische tests, zoals de Kolmogorov-Smirnov-test of de Jensen-Shannon-divergentie, kunnen die veranderingen ook kwantificeren.
Modelprestaties opvolgen
Een andere methode is de prestatiemaatstaven van het model bewaken. Maatstaven zoals accuracy, de area under the curve (AUC) en root mean square error (RMSE) geven een betrouwbaar beeld van hoe goed uw model presteert. Als u merkt dat die waarden aanhoudend verslechteren, is het mogelijk tijd om het model opnieuw te trainen.
Databricks-demo op YouTube: https://youtu.be/tGckE83S-4s?si=0Nhky3lK7WJae2n0&t=654
Tools voor driftdetectie gebruiken
Moderne tools maken driftdetectie eenvoudiger. Een voorbeeld is Evidently AI, een opensourceplatform met vooraf ingestelde evaluaties om uitgebreide driftrapporten te maken. Evidently AI kan interactieve HTML-rapporten genereren die drift zichtbaar maken in verschillende aspecten van uw data, zoals de verdeling van kenmerken en prestatiemaatstaven.
De tool levert bovendien gestructureerde uitvoer. Zo kunt u de resultaten integreren in uw workflow. Wanneer drift een bepaalde drempel bereikt, kunt u bijvoorbeeld automatisch een nieuwe modeltraining starten. Zo helpt dit proces uw modellen ook na verloop van tijd accuraat te houden, zonder voortdurende handmatige controle.
Goede praktijken voor het omgaan met drift
Stel duidelijke drempels in
Bepaal welke prestatiemaatstaven het belangrijkst zijn voor uw bedrijf. Stel drempels in die bij verslechtering een controle of nieuwe modeltraining in gang zetten.
Automatiseer de monitoring
Automatiseer waar mogelijk de monitoring van data en prestaties. Automatische waarschuwingen helpen u snel te reageren voordat drift ernstige problemen veroorzaakt.
Train opnieuw wanneer nodig
De vuistregel is: train uw model opnieuw “wanneer dat nodig is”. Sommige omgevingen veranderen langzaam en vragen mogelijk een jaarlijkse hertraining. In snel veranderende omgevingen kan dat vaker nodig zijn.
Gebruik visuele rapporten
Visuele dashboards en interactieve rapporten maken data begrijpelijker voor beslissers. Ze tonen duidelijk wanneer drift optreedt, zodat u tijdig kunt handelen.
Alles samenbrengen
Drift in machine learning is een echte uitdaging, maar hoeft geen obstakel te zijn. Door de soorten drift te begrijpen en belangrijke indicatoren op te volgen, kunt u uw modellen goed laten presteren. Of u nu handmatig monitort of een geautomatiseerd proces opzet, het komt erop aan proactief te blijven en tijdig te reageren.
Voor beslissers betekent dit dat investeren in de juiste tools en strategieën vandaag morgen veel tijd en middelen kan besparen.
Voor data scientists benadrukt dit het belang van proactief modelbeheer. De vraag is niet óf uw model drift zal vertonen, maar wanneer. U moet klaarstaan om de oorzaak te vinden en het model waar nodig bij te werken, zodat uitval, fouten & kosten beperkt blijven.
Belangrijkste inzichten
1 - Drift in machine learning verwijst naar een daling van modelprestaties door de tijd, veroorzaakt door veranderingen in data of onderliggende verbanden.
2 - Er bestaan vier soorten drift: feature, label, prediction en concept drift. Ze kunnen modellen op verschillende manieren beïnvloeden.
3 - Vroege detectie is cruciaal. Monitor zowel uw data als de prestatiemaatstaven om drift op te sporen voordat uw bedrijf er last van krijgt.
4 - Tools zoals Evidently AI helpen uitgebreide rapporten te genereren en maken automatische hertraining mogelijk wanneer de prestaties dalen.
5 - Train alleen opnieuw wanneer nodig om prestatieverbeteringen en kosten in evenwicht te houden.
Met deze principes kunnen organisaties robuuste machinelearningmodellen onderhouden die zich aanpassen aan veranderende dataomgevingen. Die proactieve aanpak verbetert niet alleen de accuracy van modellen, maar ondersteunt ook de strategische planning op lange termijn.
Hebt u vragen of wilt u strategieën voor driftbeheer verder verkennen? Neem gerust contact op en plan een telefoongesprek met onze experts. We helpen u graag om de uitdagingen van goed presterende machinelearningmodellen aan te pakken.
Klaar om uw doelen met data te bereiken?
Wilt u uw doelen bereiken door data en AI slimmer te gebruiken? Dan bent u hier op de juiste plek.
Klaar om uw doelen te bereiken met data?
Wilt u uw doelen bereiken door data en AI slimmer te gebruiken? Dan bent u hier op de juiste plaats.
Klaar om uw doelen te bereiken met data?
Wilt u uw doelen bereiken door data en AI slimmer te gebruiken? Dan bent u hier op de juiste plaats.
Klaar om uw doelen te bereiken met data?
Wilt u uw doelen bereiken door data en AI slimmer te gebruiken? Dan bent u hier op de juiste plaats.