CRISP-DM-methodologie: de 6 fasen uitgelegd

Dit model beschrijft een geïdealiseerde opeenvolging van stappen. In de praktijk kunnen veel taken in een andere volgorde worden uitgevoerd. Vaak is het nodig om terug te keren naar eerdere taken en bepaalde acties te herhalen. Het model probeert niet alle mogelijke routes door het dataminingproces te beschrijven.
Het bestaat uit de volgende fasen:
De bedrijfscontext begrijpen
De data begrijpen
Data voorbereiden
Modelleren
Evalueren
In gebruik nemen
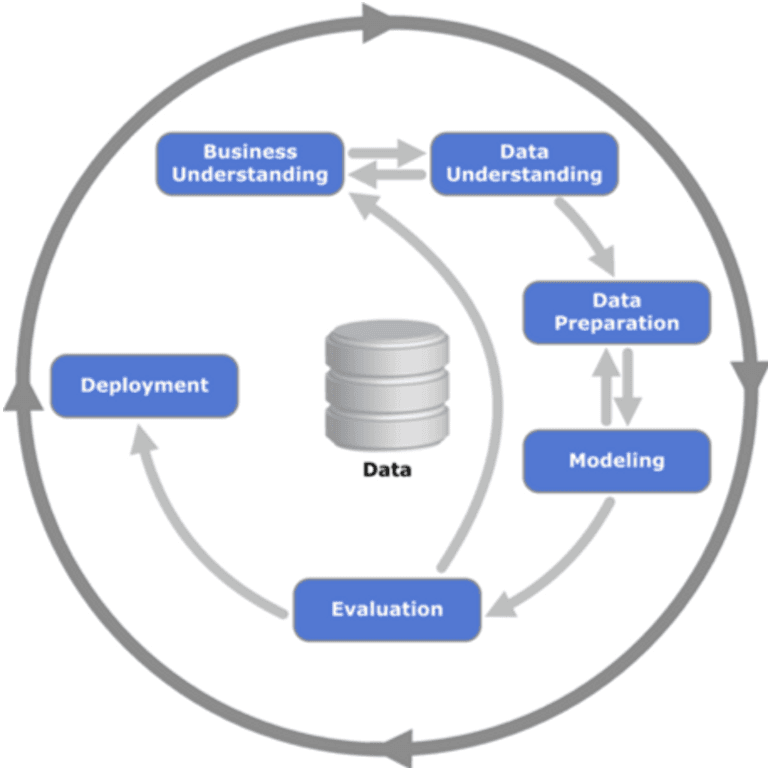
1. Bepaal de bedrijfsdoelstellingen
De eerste fase van het CRISP-DM-proces is begrijpen wat we vanuit bedrijfsoogpunt willen bereiken. Een organisatie kan te maken hebben met tegenstrijdige doelstellingen en beperkingen die zorgvuldig tegen elkaar moeten worden afgewogen. Het doel van deze fase is belangrijke factoren bloot te leggen die het resultaat van het project kunnen beïnvloeden. Wie deze stap overslaat, riskeert veel moeite te steken in de juiste antwoorden op de verkeerde vragen.
Wat moet het project opleveren?
Bepaal de doelstellingen: Beschrijf de belangrijkste doelstelling vanuit bedrijfsoogpunt. Mogelijk willen we ook andere, verwante vragen beantwoorden. Het hoofddoel kan bijvoorbeeld zijn om bestaande klanten te behouden door te voorspellen wanneer ze geneigd zijn naar een concurrent over te stappen. Verwante bedrijfsvragen zijn dan bijvoorbeeld: “Heeft het gebruikte kanaal invloed op de vraag of klanten blijven of vertrekken?” of “Zullen lagere kosten voor geldopnames aan automaten het aantal vertrekkende klanten met een hoge klantwaarde aanzienlijk verminderen?”
Stel een projectplan op: Beschrijf hoe we de dataminingdoelen en bedrijfsdoelstellingen willen bereiken. Het plan moet de stappen voor de rest van het project vastleggen, met inbegrip van een eerste selectie van tools en technieken.
Succescriteria voor het bedrijf: Leg vast met welke criteria we bepalen of het project vanuit bedrijfsoogpunt geslaagd is. Idealiter zijn die specifiek en meetbaar, bijvoorbeeld “het klantverloop terugbrengen tot een bepaald niveau”. Soms zijn echter subjectievere criteria nodig, zoals “bruikbare inzichten in de verbanden bieden”. In dat geval moet duidelijk zijn wie dat subjectieve oordeel velt.
Breng de huidige situatie in kaart
Dit houdt in dat we meer gedetailleerde informatie verzamelen over alle middelen, beperkingen, aannames en andere factoren waarmee we rekening moeten houden bij het bepalen van ons data-analysedoel en projectplan.
Overzicht van de middelen: Maak een lijst van de middelen die voor het project beschikbaar zijn, waaronder:
Medewerkers (bedrijfsexperts, data-experts, technische ondersteuning, dataminingexperts)
Data (vaste extracten, toegang tot actuele data, data in een datawarehouse of operationele data)
Rekenmiddelen (hardwareplatformen)
Software (dataminingtools, andere relevante software)
Vereisten, aannames en beperkingen: Maak een lijst van alle projectvereisten, waaronder de planning voor de afronding, de vereiste begrijpelijkheid en kwaliteit van de resultaten, en eventuele aandachtspunten rond databeveiliging en juridische kwesties. We moeten zeker weten dat we de data mogen gebruiken. Noteer de aannames waarop het project steunt. Dat kunnen aannames over de data zijn die tijdens de datamining kunnen worden gecontroleerd, maar ook niet-verifieerbare aannames over de bedrijfscontext van het project. Vooral die laatste moeten worden vastgelegd als ze de geldigheid van de resultaten beïnvloeden. Noteer de beperkingen van het project. Die kunnen te maken hebben met de beschikbaarheid van middelen, maar ook met technologie, zoals de omvang van de dataset die praktisch bruikbaar is voor modellering.
Risico’s en noodplannen: Maak een lijst van de risico’s of gebeurtenissen die het project kunnen vertragen of doen mislukken. Noteer de bijbehorende noodplannen: welke actie ondernemen we als deze risico’s of gebeurtenissen zich voordoen?
Terminologie: Stel een verklarende woordenlijst samen met termen die relevant zijn voor het project. Die bestaat doorgaans uit twee delen:
Een lijst met relevante bedrijfstermen, als onderdeel van de kennis van de bedrijfscontext die binnen het project beschikbaar is. Zo’n woordenlijst opstellen is een nuttige oefening om kennis boven tafel te krijgen en te delen.
Een lijst met dataminingtermen, geïllustreerd met voorbeelden die relevant zijn voor het bedrijfsvraagstuk.
Kosten en baten: Maak een kosten-batenanalyse voor het project. Vergelijk de projectkosten met de mogelijke voordelen voor het bedrijf als het project slaagt. Maak die vergelijking zo concreet mogelijk. Gebruik in een commerciële context bijvoorbeeld financiële maatstaven.
Bepaal de dataminingdoelen
Een bedrijfsdoel beschrijft doelstellingen in bedrijfstermen. Een dataminingdoel beschrijft de projectdoelstellingen in technische termen. Het bedrijfsdoel kan bijvoorbeeld zijn: “De catalogusverkoop aan bestaande klanten verhogen.” Een dataminingdoel kan zijn: “Voorspellen hoeveel stuks van een artikel een klant zal kopen op basis van de aankopen van de afgelopen drie jaar, demografische informatie (leeftijd, salaris, stad enz.) en de prijs van het artikel.”
Succescriteria voor het bedrijf: Beschrijf de beoogde projectresultaten die het mogelijk maken de bedrijfsdoelstellingen te bereiken.
Succescriteria voor datamining: Definieer in technische termen wanneer het project geslaagd is. Denk bijvoorbeeld aan een bepaald niveau van voorspellende nauwkeurigheid of een profiel voor aankoopgeneigdheid met een bepaalde mate van “lift”. Net als bij de succescriteria voor het bedrijf kan het nodig zijn om dit in subjectieve termen te beschrijven. Vermeld dan wie het subjectieve oordeel velt.
Stel een projectplan op
Beschrijf het plan om de dataminingdoelen en daarmee de bedrijfsdoelstellingen te bereiken. Het plan moet de stappen voor de rest van het project vastleggen, met inbegrip van een eerste selectie van tools en technieken.
Projectplan: Maak een overzicht van de uit te voeren fasen, met hun duur, benodigde middelen, input, output en onderlinge afhankelijkheden. Maak waar mogelijk de grotere iteraties in het dataminingproces expliciet, bijvoorbeeld het herhalen van de modellerings- en evaluatiefasen. Analyseer als onderdeel van het projectplan ook de samenhang tussen de planning en de risico’s. Neem de resultaten van deze analyses expliciet op in het projectplan, bij voorkeur met acties en aanbevelingen voor het geval de risico’s zich voordoen. Bepaal nu welke evaluatiestrategie in de evaluatiefase wordt gebruikt. Ons projectplan is een document dat mee evolueert. Aan het einde van elke fase bekijken we de voortgang en de bereikte resultaten en werken we het projectplan bij. Neem specifieke evaluatiemomenten voor die updates op in het projectplan.
Eerste beoordeling van tools en technieken: Aan het einde van de eerste fase moeten we een eerste beoordeling van de tools en technieken uitvoeren. We kiezen hier bijvoorbeeld een dataminingtool die verschillende methoden ondersteunt voor de verschillende procesfasen. Het is belangrijk om tools en technieken vroeg te beoordelen, omdat de keuze ervan het hele project kan beïnvloeden.
2. De data begrijpen
In de tweede fase van het CRISP-DM-proces verzamelen we de data die bij de projectmiddelen zijn vermeld. Deze eerste verzameling omvat ook het inladen van de data, als dat nodig is om ze te begrijpen. Gebruiken we bijvoorbeeld een specifieke tool om de data te verkennen, dan is het logisch om de data daarin in te laden. Als we meerdere databronnen verzamelen, moeten we nadenken over hoe en wanneer we die samenbrengen.
Verslag van de eerste dataverzameling: Noteer de verzamelde databronnen, hun locaties, de gebruikte verzamelmethoden en eventuele problemen. Leg vast welke problemen we tegenkwamen en welke oplossingen we vonden. Dat helpt zowel om dit project later te herhalen als om vergelijkbare toekomstige projecten uit te voeren.
Beschrijf de data
Onderzoek de algemene, direct waarneembare eigenschappen van de verzamelde data en rapporteer de resultaten.
Databeschrijvingsverslag: Beschrijf de verzamelde data, met hun formaat, hoeveelheid (bijvoorbeeld het aantal records en velden in elke tabel), de aanwezige velden en andere vastgestelde, direct waarneembare kenmerken. Beoordeel of de verzamelde data aan onze vereisten voldoen.
Verken de data
In deze fase beantwoorden we dataminingvragen met query’s, datavisualisatie en rapportagetechnieken. Daarbij kunnen we onder meer kijken naar:
De verdeling van belangrijke kenmerken (bijvoorbeeld het doelkenmerk bij een voorspeltaak)
Verbanden tussen twee of een klein aantal kenmerken
Resultaten van eenvoudige aggregaties
Eigenschappen van relevante deelpopulaties
Eenvoudige statistische analyses
Deze analyses kunnen rechtstreeks bijdragen aan onze dataminingdoelen. Ze kunnen ook de databeschrijving en kwaliteitsverslagen aanvullen of verfijnen, en richting geven aan de transformaties en andere datavoorbereiding die nodig zijn voor verdere analyse.
Dataverkenningsverslag: Beschrijf de resultaten van onze dataverkenning, met de eerste bevindingen of aanvankelijke hypothesen en hun invloed op de rest van het project. Waar relevant kunnen we grafieken opnemen die datakenmerken tonen die aanleiding geven om interessante deelverzamelingen verder te onderzoeken.
Controleer de datakwaliteit
Onderzoek de kwaliteit van de data aan de hand van vragen zoals:
Zijn de data volledig (omvatten ze alle benodigde gevallen)?
Zijn ze correct of bevatten ze fouten? En als er fouten zijn, hoe vaak komen die voor?
Ontbreken er waarden in de data? Zo ja, hoe wordt dat aangegeven, waar ontbreken ze en hoe vaak?
Datakwaliteitsverslag: Noteer de resultaten van de datakwaliteitscontrole. Stel mogelijke oplossingen voor als er kwaliteitsproblemen zijn. Oplossingen voor datakwaliteitsproblemen hangen doorgaans sterk af van zowel datakennis als kennis van de bedrijfscontext.
3. Data voorbereiden
Selecteer de data
In deze projectfase beslissen we welke data we voor de analyse gaan gebruiken. Mogelijke selectiecriteria zijn de relevantie voor onze dataminingdoelen, de datakwaliteit en technische beperkingen, zoals grenzen aan het datavolume of de datatypes. Dataselectie omvat zowel het selecteren van kenmerken (kolommen) als van records (rijen) in een tabel.
Onderbouwing van opname of uitsluiting: Noteer welke data worden opgenomen of uitgesloten en waarom.
Schoon de data op
Deze taak brengt de datakwaliteit op het niveau dat de gekozen analysetechnieken vereisen. Dat kan betekenen dat we schone deelverzamelingen selecteren, geschikte standaardwaarden invullen of verdergaande technieken gebruiken, zoals ontbrekende data schatten met modellen.
Verslag van de dataopschoning: Beschrijf welke beslissingen en acties we namen om datakwaliteitsproblemen aan te pakken. Bespreek eventuele datatransformaties voor de opschoning en hun mogelijke invloed op de analyseresultaten.
Maak de benodigde data aan
Deze taak omvat bewerkingen waarbij we nieuwe data opbouwen, zoals afgeleide kenmerken, volledig nieuwe records of getransformeerde waarden voor bestaande kenmerken.
Afgeleide kenmerken: Dit zijn nieuwe kenmerken die worden opgebouwd uit één of meer bestaande kenmerken in hetzelfde record. We kunnen bijvoorbeeld de variabelen lengte en breedte gebruiken om een nieuwe variabele oppervlakte te berekenen.
Gegenereerde records: Beschrijf hier hoe volledig nieuwe records worden aangemaakt. Zo kan het nodig zijn om records aan te maken voor klanten die het afgelopen jaar niets hebben gekocht. Er was geen reden om zulke records in de ruwe data op te nemen. Voor de modellering kan het echter zinvol zijn om expliciet weer te geven dat bepaalde klanten nul aankopen deden.
Breng de data samen
Dit zijn methoden om informatie uit meerdere databases, tabellen of records te combineren tot nieuwe records of waarden.
Samengevoegde data: “Tabellen samenvoegen” betekent twee of meer tabellen koppelen die verschillende informatie over dezelfde objecten bevatten. Een winkelketen kan bijvoorbeeld één tabel hebben met de algemene kenmerken van elke winkel (zoals vloeroppervlakte en type winkelcentrum), een andere met samengevatte verkoopgegevens (zoals winst en procentuele verandering van de verkoop ten opzichte van het voorgaande jaar), en nog een andere met demografische informatie over de omgeving. Elk van deze tabellen bevat één record per winkel. Ze kunnen worden samengevoegd tot een nieuwe tabel met één record per winkel, waarin velden uit de brontabellen worden gecombineerd.
Aggregaties: Bij aggregaties worden nieuwe waarden berekend door informatie uit meerdere records en/of tabellen samen te vatten. Een tabel met klantaankopen en één record per aankoop kan bijvoorbeeld worden omgezet in een nieuwe tabel met één record per klant. Die bevat dan velden zoals het aantal aankopen, het gemiddelde aankoopbedrag, het percentage bestellingen betaald met een kredietkaart, het percentage artikelen in promotie enz.
4. Modelleren
Kies de modelleringstechniek
Als eerste stap kiezen we de concrete modelleringstechniek die we gaan gebruiken. Ook als we tijdens het verkennen van de bedrijfscontext al een tool hebben gekozen, selecteren we nu de specifieke techniek. Denk bijvoorbeeld aan beslissingsbomen bouwen met C5.0 of neurale netwerken opbouwen met backpropagation. Als we meerdere technieken toepassen, voeren we deze taak voor elke techniek afzonderlijk uit.
Modelleringstechniek: Leg vast welke concrete modelleringstechniek wordt gebruikt.
Aannames bij de modellering: Veel modelleringstechnieken gaan uit van specifieke aannames over de data. Bijvoorbeeld dat alle kenmerken uniform verdeeld zijn, dat ontbrekende waarden niet toegestaan zijn of dat het klassekenmerk symbolisch moet zijn. Leg alle aannames vast.
Stel een testopzet op
Voordat we een model bouwen, moeten we een procedure of mechanisme opstellen om de kwaliteit en geldigheid ervan te testen. Bij dataminingtaken met supervisie, zoals classificatie, worden bijvoorbeeld vaak foutpercentages gebruikt als kwaliteitsmaatstaf voor de modellen. Daarom splitsen we de dataset doorgaans op in een trainingsset en een testset. We bouwen het model met de trainingsset en schatten de kwaliteit op de afzonderlijke testset.
Testopzet: Beschrijf het plan voor het trainen, testen en evalueren van de modellen. Een belangrijk onderdeel is bepalen hoe de beschikbare dataset wordt opgesplitst in trainings-, test- en validatiedata.
Bouw het model
Voer de modelleringstool uit op de voorbereide dataset om één of meer modellen te maken.
Parameterinstellingen: Een modelleringstool heeft vaak heel wat instelbare parameters. Noteer de parameters en hun gekozen waarden, samen met de onderbouwing van die keuzes.
Modellen: Dit zijn de modellen zelf die de modelleringstool oplevert, niet een verslag over de modellen.
Modelbeschrijvingen: Beschrijf de verkregen modellen, rapporteer hoe ze worden geïnterpreteerd en leg eventuele moeilijkheden bij die interpretatie vast.
Beoordeel het model
Interpreteer de modellen aan de hand van onze domeinkennis, onze succescriteria voor datamining en onze gewenste testopzet. Beoordeel vanuit technisch oogpunt hoe succesvol de modellerings- en patroonontdekkingstechnieken zijn toegepast. Bespreek daarna de dataminingresultaten met businessanalisten en domeinexperts in hun bedrijfscontext. Deze taak gaat alleen over de modellen, terwijl de evaluatiefase ook alle andere projectresultaten in aanmerking neemt.
In deze fase moeten we de modellen rangschikken en beoordelen volgens de evaluatiecriteria. Daarbij houden we zo veel mogelijk rekening met de bedrijfsdoelstellingen en de bijbehorende succescriteria. In de meeste dataminingprojecten wordt eenzelfde techniek meermaals toegepast en worden resultaten verkregen met verschillende technieken.
Modelbeoordeling: Vat de resultaten van deze taak samen, vermeld de kwaliteit van de gemaakte modellen (bijvoorbeeld op het vlak van accuracy) en rangschik ze ten opzichte van elkaar.
Herziene parameterinstellingen: Pas de parameterinstellingen aan op basis van de modelbeoordeling en stem ze af voor de volgende modelleringsronde. Herhaal het bouwen en beoordelen van modellen tot we er sterk van overtuigd zijn dat we het beste model of de beste modellen hebben gevonden. Leg al die aanpassingen en beoordelingen vast.
5. Evalueren
Evalueer de resultaten
Eerdere evaluatiestappen gingen over factoren zoals de accuracy en de generaliseerbaarheid van het model. In deze stap beoordelen we in welke mate het model onze bedrijfsdoelstellingen haalt en gaan we na of het vanuit bedrijfsoogpunt tekortschiet. Een andere mogelijkheid is om de modellen te testen met proefgebruik in de echte toepassing, als tijd en budget dat toelaten. In de evaluatiefase beoordelen we ook alle andere dataminingresultaten die u hebt verkregen. Dataminingresultaten omvatten modellen die noodzakelijkerwijs verband houden met de oorspronkelijke bedrijfsdoelstellingen, en alle andere bevindingen die daar niet noodzakelijk verband mee houden. Die kunnen wel bijkomende uitdagingen, informatie of aanwijzingen voor toekomstige richtingen aan het licht brengen.
Beoordeling van de dataminingresultaten: Vat de beoordeling samen aan de hand van de succescriteria voor het bedrijf. Geef daarbij een eindoordeel over de vraag of het project al aan de oorspronkelijke bedrijfsdoelstellingen voldoet.
Goedgekeurde modellen: Na de beoordeling aan de hand van de succescriteria voor het bedrijf worden de gemaakte modellen die aan de gekozen criteria voldoen, goedgekeurd.
Evalueer het proces
Op dit punt lijken de verkregen modellen bevredigend en lijken ze aan de bedrijfsbehoeften te voldoen. Nu is het zinvol om het dataminingproject grondiger te bekijken en na te gaan of er een belangrijke factor of taak over het hoofd is gezien. Deze evaluatie omvat ook kwaliteitsborging. Hebben we het model bijvoorbeeld correct gebouwd? Hebben we alleen kenmerken gebruikt die we mogen gebruiken en die beschikbaar zijn voor toekomstige analyses?
Procesevaluatie: Vat de evaluatie van het proces samen en benoem activiteiten die zijn overgeslagen of die opnieuw moeten worden uitgevoerd.
Bepaal de volgende stappen
Op basis van de beoordeling en de procesevaluatie beslissen we hoe we verdergaan. Ronden we dit project af en gaan we over tot ingebruikname, starten we nieuwe iteraties of zetten we nieuwe dataminingprojecten op? We moeten ook bekijken welke middelen en welk budget nog beschikbaar zijn, want dat kan onze beslissingen beïnvloeden.
Lijst met mogelijke acties: Noteer de mogelijke vervolgstappen, met de argumenten voor en tegen elke optie.
Beslissing: Beschrijf hoe we verdergaan en waarom.
6. In gebruik nemen
Plan de ingebruikname
In deze fase gebruiken we onze evaluatieresultaten om een strategie voor de ingebruikname te bepalen. Als er een algemene procedure is gevonden om de relevante modellen te maken, leggen we die hier vast voor latere ingebruikname. Het is zinvol om ook bij het verkennen van de bedrijfscontext al na te denken over de manier waarop en de middelen waarmee we de resultaten in gebruik nemen. Die ingebruikname is immers cruciaal voor het succes van het project. Hier helpt voorspellende analytics echt om de operationele werking van ons bedrijf te verbeteren.
Plan voor ingebruikname: Vat onze strategie voor ingebruikname samen, met de noodzakelijke stappen en de manier waarop we die uitvoeren.
Plan monitoring en onderhoud
Monitoring en onderhoud zijn belangrijk als het dataminingresultaat deel gaat uitmaken van de dagelijkse bedrijfswerking en de bijbehorende omgeving. Een zorgvuldig voorbereide onderhoudsstrategie helpt te voorkomen dat dataminingresultaten onnodig lang verkeerd worden gebruikt. Om de ingebruikname van de dataminingresultaten te volgen, heeft het project een gedetailleerd monitoringplan nodig. Dat plan houdt rekening met de specifieke manier waarop de resultaten in gebruik worden genomen.
Monitoring- en onderhoudsplan: Vat de strategie voor monitoring en onderhoud samen, met de noodzakelijke stappen en de manier waarop we die uitvoeren.
Stel het eindverslag op
Aan het einde van het project schrijven we een eindverslag. Afhankelijk van het plan voor ingebruikname kan dat enkel een samenvatting zijn van het project en de opgedane ervaringen, als die nog niet doorlopend zijn vastgelegd. Het kan ook een definitieve, uitgebreide presentatie van de dataminingresultaten zijn.
Eindverslag: Dit is het definitieve schriftelijke verslag van het dataminingproject. Het omvat alle eerdere opgeleverde onderdelen en vat de resultaten samen in een overzichtelijk geheel.
Eindpresentatie: Vaak is er bij de afronding van het project ook een bijeenkomst waarin de resultaten aan de klant worden gepresenteerd.
Evalueer het project
Beoordeel wat goed en fout liep, wat goed werd uitgevoerd en wat beter moet.
Ervaringen vastleggen: Vat belangrijke ervaringen uit het project samen. Denk bijvoorbeeld aan valkuilen die we tegenkwamen, misleidende benaderingen of tips om in vergelijkbare situaties de meest geschikte dataminingtechnieken te kiezen. Idealiter omvat deze documentatie ook alle verslagen die individuele projectleden tijdens eerdere projectfasen hebben geschreven.
Wilt u CRISP-DM toepassen op uw volgende data- of AI-project? Lees hoe we data-scienceprojecten beheren, of neem contact met ons op.