Méthode CRISP-DM: les 6 phases expliquées

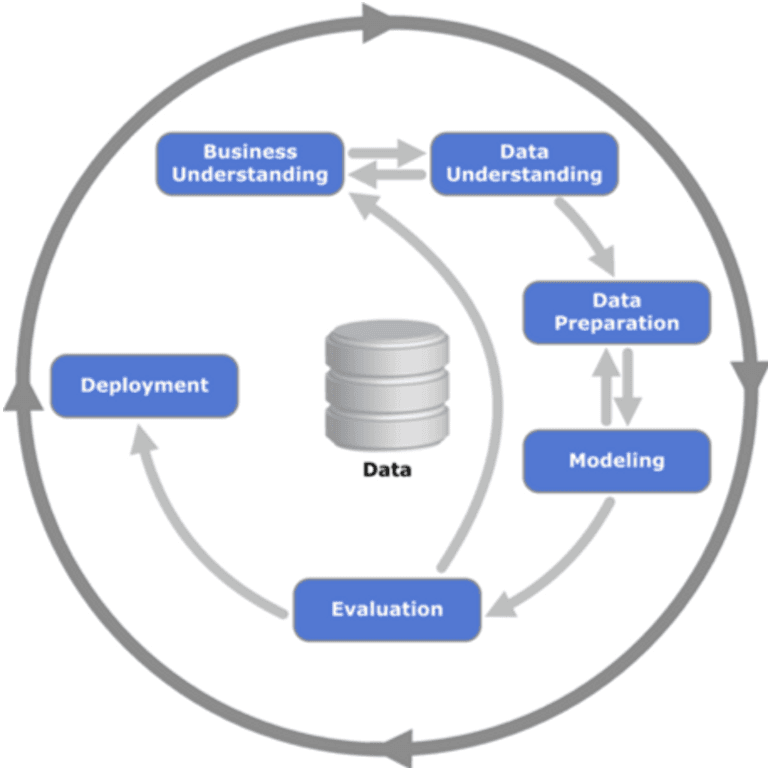
Ce modèle décrit une séquence idéalisée. En pratique, de nombreuses tâches peuvent être réalisées dans un ordre différent, et il faudra souvent revenir à des tâches précédentes pour répéter certaines actions. Le modèle ne cherche pas à couvrir tous les chemins possibles d'un projet de data mining.
Il s'articule autour des phases suivantes:
Compréhension du métier (business understanding)
Compréhension des données (data understanding)
Préparation des données (data preparation)
Modélisation (modeling)
Évaluation (evaluation)
Déploiement (deployment)
1. Définir les objectifs métier
La première phase du processus CRISP-DM consiste à comprendre ce que nous voulons accomplir d'un point de vue métier. Une organisation peut avoir des objectifs et des contraintes concurrents qu'il faut équilibrer. Le but de cette phase est de mettre au jour les facteurs importants qui pourraient influencer le résultat du projet. Négliger cette étape, c'est risquer de consacrer beaucoup d'efforts à produire les bonnes réponses aux mauvaises questions.
Quels sont les résultats attendus du projet?
Fixer les objectifs: Il s'agit de décrire l'objectif principal d'un point de vue métier. D'autres questions liées peuvent aussi mériter une réponse. Par exemple, l'objectif principal peut être de conserver les clients actuels en prédisant quand ils risquent de passer à la concurrence. Des questions métier liées pourraient être “Le canal utilisé influence-t-il le départ ou la fidélité des clients?” ou “Des frais de retrait moins élevés réduiraient-ils sensiblement le nombre de clients à forte valeur qui partent?”
Établir le plan de projet: Nous décrivons ici le plan pour atteindre les objectifs de data mining et les objectifs métier. Le plan doit préciser les étapes à mener pendant le reste du projet, y compris la sélection initiale des outils et des techniques.
Critères de succès métier: Nous définissons ici les critères qui permettront de juger si le projet est une réussite d'un point de vue métier. Ils doivent idéalement être précis et mesurables, par exemple “réduire l'attrition des clients à un certain niveau”. Il peut toutefois être nécessaire de recourir à des critères plus subjectifs, comme “apporter des éclairages utiles sur les relations”. Dans ce cas, il faut établir clairement qui porte ce jugement subjectif.
Évaluer la situation actuelle
Cette étape demande un travail plus détaillé de collecte d'informations sur l'ensemble des ressources, contraintes, hypothèses et autres facteurs à prendre en compte pour définir l'objectif d'analyse et le plan de projet.
Inventaire des ressources: Lister les ressources disponibles pour le projet, notamment:
Les personnes (experts métier, experts des données, support technique, experts en data mining)
Les données (extractions figées, accès aux données en temps réel, entreposées ou opérationnelles)
Les ressources informatiques (plateformes matérielles)
Les logiciels (outils de data mining, autres logiciels utiles)
Exigences, hypothèses et contraintes: Lister toutes les exigences du projet, y compris le calendrier de réalisation, le niveau de compréhension et de qualité attendu des résultats, les enjeux de sécurité des données et les questions juridiques. Il faut s'assurer que nous avons le droit d'utiliser les données. Lister les hypothèses du projet. Il peut s'agir d'hypothèses sur les données, vérifiables pendant le data mining, mais aussi d'hypothèses non vérifiables sur l'activité liée au projet. Il est particulièrement important de lister ces dernières si elles affectent la validité des résultats. Lister les contraintes du projet. Il peut s'agir de contraintes sur la disponibilité des ressources, mais aussi de contraintes technologiques, comme la taille du jeu de données qu'il est réaliste d'utiliser pour la modélisation.
Risques et plans de secours: Lister les risques ou événements susceptibles de retarder le projet ou de le faire échouer. Lister les plans de secours correspondants: quelle action prendrons-nous si ces risques ou événements se produisent?
Terminologie: Constituer un glossaire des termes utiles au projet. Il comporte en général deux volets:
Un glossaire des termes métier, qui fait partie de la compréhension du métier dont dispose le projet. Construire ce glossaire est un exercice utile de recueil des connaissances et de formation.
Un glossaire des termes de data mining, illustré d'exemples liés au problème métier concerné.
Coûts et bénéfices: Réaliser une analyse coûts-bénéfices du projet, qui compare ses coûts aux bénéfices potentiels pour l'entreprise en cas de réussite. Cette comparaison doit être aussi précise que possible. Par exemple, utiliser des indicateurs financiers dans un contexte commercial.
Définir les objectifs de data mining
Un objectif métier exprime les objectifs dans les termes de l'entreprise. Un objectif de data mining exprime les objectifs du projet en termes techniques. Par exemple, l'objectif métier pourrait être “augmenter les ventes sur catalogue auprès des clients existants”. Un objectif de data mining pourrait être “prédire combien de produits un client achètera, compte tenu de ses achats des trois dernières années, de données démographiques (âge, salaire, ville, etc.) et du prix de l'article”.
Critères de succès métier: décrire les résultats attendus du projet qui permettent d'atteindre les objectifs métier.
Critères de succès du data mining: définir en termes techniques les critères de réussite du projet, par exemple un certain niveau de précision prédictive ou un profil de propension à l'achat avec un certain niveau de “lift”. Comme pour les critères de succès métier, il peut être nécessaire de les exprimer en termes subjectifs. Dans ce cas, il faut identifier la ou les personnes qui portent ce jugement.
Établir le plan de projet
Décrire le plan prévu pour atteindre les objectifs de data mining et, par là, les objectifs métier. Le plan doit préciser les étapes à mener pendant le reste du projet, y compris la sélection initiale des outils et des techniques.
Plan de projet: Lister les étapes du projet avec leur durée, les ressources nécessaires, les entrées, les sorties et les dépendances. Dans la mesure du possible, rendre explicites les grandes itérations du processus de data mining, par exemple la répétition des phases de modélisation et d'évaluation. Dans le plan de projet, il est aussi important d'analyser les dépendances entre le calendrier et les risques. Indiquer explicitement les résultats de ces analyses dans le plan, idéalement avec des actions et des recommandations si les risques se matérialisent. Décider dès ce stade de la stratégie d'évaluation qui sera utilisée lors de la phase d'évaluation. Notre plan de projet est un document vivant: à la fin de chaque phase, nous passons en revue les progrès et les réalisations et nous mettons le plan à jour. Des points de revue précis pour ces mises à jour doivent faire partie du plan de projet.
Évaluation initiale des outils et des techniques: À la fin de la première phase, nous devons procéder à une première évaluation des outils et des techniques. Nous choisissons par exemple un outil de data mining qui prend en charge différentes méthodes pour les différentes étapes du processus. Il est important d'évaluer tôt les outils et les techniques, car leur choix peut influencer l'ensemble du projet.
2. Compréhension des données
La deuxième phase du processus CRISP-DM consiste à acquérir les données listées dans les ressources du projet. Cette collecte initiale comprend le chargement des données, si c'est nécessaire pour les comprendre. Par exemple, si nous utilisons un outil spécifique pour comprendre les données, il est logique d'y charger nos données. Si nous acquérons plusieurs sources de données, nous devons réfléchir à la manière et au moment de les intégrer.
Rapport de collecte initiale des données: Lister les sources de données acquises, avec leur emplacement, les méthodes utilisées pour les obtenir et les problèmes rencontrés. Consigner les problèmes rencontrés et les solutions trouvées. Cela facilitera aussi bien la reproduction de ce projet que la conduite de projets similaires.
Décrire les données
Examiner les propriétés “brutes” ou “de surface” des données acquises et rendre compte des résultats.
Rapport de description des données: Décrire les données acquises, y compris leur format, leur volume (par exemple le nombre d'enregistrements et de champs de chaque table), l'identité des champs et toute autre caractéristique de surface constatée. Évaluer si les données acquises répondent à nos besoins.
Explorer les données
Pendant cette étape, nous traitons des questions de data mining à l'aide de requêtes, de visualisations et de techniques de reporting. Par exemple:
La distribution des attributs clés (par exemple l'attribut cible d'une tâche de prédiction)
Les relations entre des paires ou de petits groupes d'attributs
Les résultats d'agrégations simples
Les propriétés de sous-populations significatives
Des analyses statistiques simples
Ces analyses peuvent répondre directement à nos objectifs de data mining. Elles peuvent aussi compléter ou affiner les rapports de description et de qualité des données, et alimenter les transformations et autres étapes de préparation nécessaires à la suite de l'analyse.
Rapport d'exploration des données: Décrire les résultats de l'exploration des données, y compris les premiers constats ou hypothèses et leur impact sur la suite du projet. Si c'est pertinent, ajouter des graphiques montrant les caractéristiques des données qui justifient d'examiner plus en détail certains sous-ensembles intéressants.
Vérifier la qualité des données
Examiner la qualité des données en répondant à des questions comme:
Les données sont-elles complètes (couvrent-elles tous les cas nécessaires)?
Sont-elles correctes ou contiennent-elles des erreurs et, le cas échéant, à quelle fréquence?
Y a-t-il des valeurs manquantes? Si oui, comment sont-elles représentées, où apparaissent-elles et à quelle fréquence?
Rapport de qualité des données: Lister les résultats de la vérification de la qualité des données. En cas de problèmes de qualité, proposer des solutions. Ces solutions dépendent en général fortement de la connaissance des données et du métier.
3. Préparation des données
Sélectionner les données
C'est à ce stade du projet que nous décidons des données à utiliser pour l'analyse. Les critères de décision peuvent inclure la pertinence des données au regard de nos objectifs de data mining, leur qualité, ainsi que des contraintes techniques comme les limites de volume ou de types de données. La sélection porte aussi bien sur les attributs (colonnes) que sur les enregistrements (lignes) d'une table.
Justification de l'inclusion ou de l'exclusion: Lister les données à inclure ou à exclure et les raisons de ces choix.
Nettoyer les données
Cette tâche consiste à porter la qualité des données au niveau exigé par les techniques d'analyse choisies. Cela peut passer par la sélection de sous-ensembles propres, l'insertion de valeurs par défaut adaptées ou des techniques plus ambitieuses, comme l'estimation des données manquantes par modélisation.
Rapport de nettoyage des données: Décrire les décisions et actions prises pour traiter les problèmes de qualité des données. Tenir compte des transformations appliquées pour le nettoyage et de leur impact possible sur les résultats de l'analyse.
Construire les données nécessaires
Cette tâche comprend les opérations de préparation constructives, comme la création d'attributs dérivés, d'enregistrements entièrement nouveaux ou de valeurs transformées pour des attributs existants.
Attributs dérivés: Ce sont de nouveaux attributs construits à partir d'un ou plusieurs attributs existants du même enregistrement. Par exemple, nous pouvons utiliser la longueur et la largeur pour calculer une nouvelle variable de surface.
Enregistrements générés: Nous décrivons ici la création d'enregistrements entièrement nouveaux. Par exemple, il peut être nécessaire de créer des enregistrements pour les clients qui n'ont rien acheté au cours de l'année écoulée. Ces enregistrements n'avaient pas de raison d'exister dans les données brutes, mais pour la modélisation, il peut être utile de représenter explicitement le fait que certains clients n'ont effectué aucun achat.
Intégrer les données
Il s'agit des méthodes qui combinent des informations issues de plusieurs bases de données, tables ou enregistrements pour créer de nouveaux enregistrements ou de nouvelles valeurs.
Données fusionnées: “Fusionner des tables” consiste à joindre deux tables ou plus qui contiennent des informations différentes sur les mêmes objets. Par exemple, une chaîne de magasins peut avoir une table avec les caractéristiques générales de chaque magasin (surface, type de centre commercial), une autre avec des données de ventes résumées (bénéfice, évolution des ventes en pourcentage par rapport à l'année précédente) et une troisième avec les données démographiques de la zone environnante. Chacune de ces tables contient un enregistrement par magasin. Elles peuvent être fusionnées en une nouvelle table avec un enregistrement par magasin, qui combine les champs des tables sources.
Agrégations: Les agrégations désignent les opérations qui calculent de nouvelles valeurs en résumant des informations issues de plusieurs enregistrements ou tables. Par exemple, convertir une table des achats clients, avec un enregistrement par achat, en une nouvelle table avec un enregistrement par client et des champs comme le nombre d'achats, le montant moyen d'achat, la part des commandes payées par carte de crédit ou la part des articles en promotion.
4. Modélisation
Choisir la technique de modélisation
Première étape de la modélisation: choisir la technique que nous allons réellement utiliser. Même si un outil a déjà été choisi pendant la phase de compréhension du métier, nous choisissons ici la technique précise, par exemple la construction d'un arbre de décision avec C5.0 ou un réseau de neurones entraîné par rétropropagation. Si plusieurs techniques sont appliquées, mener cette tâche séparément pour chacune.
Technique de modélisation: Documenter la technique de modélisation retenue.
Hypothèses de modélisation: De nombreuses techniques de modélisation reposent sur des hypothèses précises sur les données, par exemple que tous les attributs suivent une distribution uniforme, qu'aucune valeur ne manque ou que l'attribut de classe est symbolique. Consigner toutes les hypothèses retenues.
Définir le protocole de test
Avant de construire un modèle, nous devons définir une procédure ou un mécanisme pour en tester la qualité et la validité. Par exemple, dans les tâches de data mining supervisées comme la classification, on utilise couramment les taux d'erreur comme mesures de qualité. Nous séparons donc en général le jeu de données en un jeu d'entraînement et un jeu de test, nous construisons le modèle sur le premier et nous estimons sa qualité sur le second.
Protocole de test: Décrire le plan prévu pour entraîner, tester et évaluer les modèles. Un élément clé du plan est la manière de répartir le jeu de données disponible entre entraînement, test et validation.
Construire le modèle
Exécuter l'outil de modélisation sur le jeu de données préparé pour créer un ou plusieurs modèles.
Paramétrage: Tout outil de modélisation comporte souvent de nombreux paramètres ajustables. Lister les paramètres et les valeurs choisies, avec la justification de ces choix.
Modèles: Il s'agit des modèles produits par l'outil de modélisation, et non d'un rapport sur ces modèles.
Description des modèles: Décrire les modèles obtenus, rendre compte de leur interprétation et documenter les difficultés rencontrées pour en comprendre le sens.
Évaluer le modèle
Interpréter les modèles au regard de notre connaissance du domaine, de nos critères de succès en data mining et du protocole de test prévu. Juger d'abord techniquement la réussite de l'application des techniques de modélisation et de découverte, puis échanger avec les analystes métier et les experts du domaine pour discuter des résultats dans leur contexte métier. Cette tâche ne porte que sur les modèles, alors que la phase d'évaluation prend aussi en compte tous les autres résultats produits au cours du projet.
À ce stade, nous classons les modèles et les évaluons selon les critères d'évaluation. Nous tenons compte autant que possible des objectifs métier et des critères de succès métier. Dans la plupart des projets de data mining, une même technique est appliquée plusieurs fois et les résultats sont produits avec plusieurs techniques différentes.
Évaluation des modèles: Résumer les résultats de cette tâche, lister les qualités des modèles obtenus (par exemple en termes de précision) et classer leur qualité les uns par rapport aux autres.
Paramétrage révisé: Selon l'évaluation des modèles, revoir et ajuster le paramétrage pour la prochaine itération de modélisation. Répéter la construction et l'évaluation des modèles jusqu'à être convaincu d'avoir trouvé le ou les meilleurs modèles. Documenter toutes ces révisions et évaluations.
5. Évaluation
Évaluer les résultats
Les étapes d'évaluation précédentes portaient sur des facteurs comme la précision et la capacité de généralisation du modèle. Ici, nous évaluons dans quelle mesure le modèle répond à nos objectifs métier et cherchons à savoir si une raison métier le rend insuffisant. Une autre option consiste à tester le ou les modèles sur des cas réels, si le temps et le budget le permettent. La phase d'évaluation porte aussi sur tous les autres résultats de data mining obtenus. Ces résultats comprennent les modèles, nécessairement liés aux objectifs métier initiaux, et tous les autres constats, qui ne le sont pas forcément mais peuvent révéler de nouveaux défis, des informations ou des pistes pour la suite.
Évaluation des résultats de data mining: Résumer les résultats de l'évaluation au regard des critères de succès métier, avec une conclusion indiquant si le projet atteint déjà les objectifs métier initiaux.
Modèles approuvés: Après évaluation au regard des critères de succès métier, les modèles qui remplissent les critères retenus deviennent les modèles approuvés.
Revoir le processus
À ce stade, les modèles obtenus semblent satisfaisants et répondent aux besoins métier. Il est alors temps de mener une revue plus approfondie de la mission de data mining, pour vérifier qu'aucun facteur ou tâche important n'a été négligé. Cette revue couvre aussi l'assurance qualité, par exemple: avons-nous construit le modèle correctement? Avons-nous utilisé uniquement les attributs que nous avons le droit d'utiliser et qui seront disponibles pour les analyses futures?
Revue du processus: Résumer la revue du processus et mettre en évidence les activités oubliées et celles qui doivent être répétées.
Déterminer les prochaines étapes
Selon les résultats de l'évaluation et de la revue du processus, nous décidons de la suite. Faut-il clore ce projet et passer au déploiement, lancer de nouvelles itérations ou démarrer de nouveaux projets de data mining? Nous faisons aussi le point sur les ressources et le budget restants, qui peuvent influencer nos décisions.
Liste des actions possibles: Lister les actions envisageables, avec les arguments pour et contre chacune.
Décision: Décrire la décision sur la suite à donner, avec sa justification.
6. Déploiement
Planifier le déploiement
Lors de la phase de déploiement, nous partons des résultats de l'évaluation pour définir une stratégie de déploiement. Si une procédure générale a été identifiée pour créer le ou les modèles concernés, elle est documentée ici en vue du déploiement. Il est utile de réfléchir aux modalités de déploiement dès la phase de compréhension du métier, car le déploiement est absolument décisif pour la réussite du projet. C'est là que l'analytique prédictive aide vraiment à améliorer le fonctionnement opérationnel de l'entreprise.
Plan de déploiement: Résumer la stratégie de déploiement, avec les étapes nécessaires et la manière de les mener.
Planifier le suivi et la maintenance
Le suivi et la maintenance sont des enjeux importants lorsque le résultat du data mining entre dans l'activité quotidienne et son environnement. Préparer soigneusement une stratégie de maintenance évite de longues périodes d'utilisation incorrecte des résultats. Pour suivre le déploiement du ou des résultats, le projet a besoin d'un plan de suivi détaillé, qui tient compte du type de déploiement.
Plan de suivi et de maintenance: Résumer la stratégie de suivi et de maintenance, avec les étapes nécessaires et la manière de les mener.
Rédiger le rapport final
À la fin du projet, nous rédigeons un rapport final. Selon le plan de déploiement, ce rapport peut n'être qu'une synthèse du projet et des enseignements tirés (s'ils n'ont pas déjà été documentés en cours de route), ou une présentation finale et complète des résultats du data mining.
Rapport final: Il s'agit du rapport écrit final de la mission de data mining. Il reprend tous les livrables précédents, en résumant et en organisant les résultats.
Présentation finale: Une réunion de clôture est aussi souvent organisée pour présenter les résultats au client.
Faire le bilan du projet
Évaluer ce qui a fonctionné et ce qui n'a pas fonctionné, ce qui a été bien fait et ce qui doit être amélioré.
Capitalisation de l'expérience: Résumer les principaux enseignements du projet. Par exemple, les écueils rencontrés, les approches trompeuses ou les conseils pour choisir les techniques de data mining les plus adaptées dans des situations similaires peuvent faire partie de cette documentation. Dans l'idéal, elle comprend aussi les rapports rédigés par les membres de l'équipe lors des phases précédentes du projet.
Vous souhaitez appliquer CRISP-DM à votre prochain projet data ou IA? Découvrez comment nous gérons nos projets de data science, ou contactez-nous.